인공지능(AI) 반도체 스타트업 하이퍼엑셀이 고대역폭메모리(HBM)를 뺀 거대언어모델(LLM) 전용 추론 서버를 처음 공개했다.
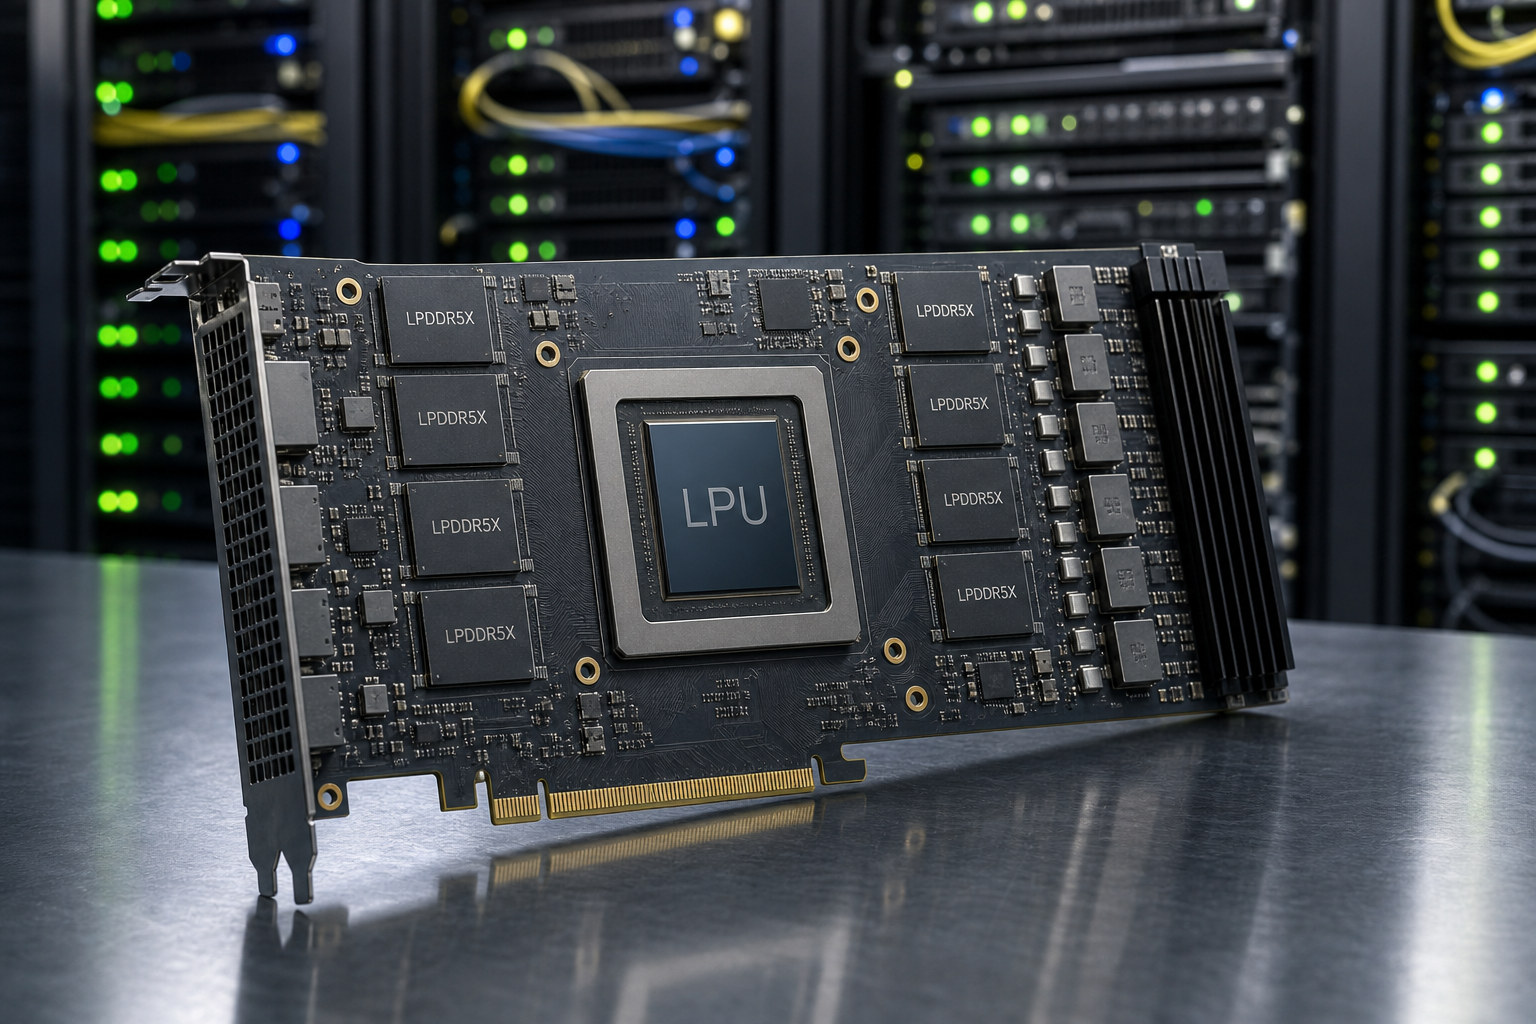
하이퍼엑셀은 16일(현지시간) 미국 시카고 맥코믹 플레이스에서 열리는 글로벌 슈퍼컴퓨팅 행사 'SC26'에 참가해 독자 개발한 추론 가속기(LPU) 기반 서버 시스템을 선보인다고 밝혔다.
이번 전시에서 하이퍼엑셀은 LPU 8개를 탑재한 서버를 공개하고, 국내에서 운영 중인 시스템과 실시간 연동해 Qwen3-32B와 Llama3-70B 모델의 추론 처리를 시연한다.
회사가 공개한 자체 벤치마크에 따르면 하이퍼엑셀 LPU 서버는 엔비디아의 최신 서버용 가속기 RTX PRO 6000 블랙웰 서버 에디션 GPU 시스템 대비 전력당(와트당)·비용당(달러당) 토큰 처리량에서 각각 3.5배 이상의 효율을 기록했다.
카드 한 장당 소비전력도 엔비디아 GPU의 600W에 비해 250W에 그쳐 약 58% 낮았다.
이 같은 효율 격차는 메모리 설계에서 비롯됐다. 하이퍼엑셀은 공급 부족과 가격 급등을 겪는 HBM 대신 저렴한 저전력 범용 메모리(LPDDR5X)를 채택했다.
여기에 자체 개발한 '스트림라인드 데이터플로' 아키텍처를 결합해 메모리에서 불러온 가중치를 코어 내부에서 최대한 재활용하도록 경로를 최적화했다. 이를 통해 대역폭 활용률을 약 90%까지 끌어올렸다.
다만 자체 벤치마크의 수치 우위가 곧바로 상용화 성공을 보장하지는 않는다. 기업용 데이터센터나 클라우드 서비스 제공업체(CSP)는 하드웨어 단품 성능보다 엔비디아의 쿠다(CUDA)처럼 견고한 소프트웨어 생태계와 호환성을 필수 조건으로 요구하기 때문이다.
하이퍼엑셀의 성패는 이번 SC26에서 시작되는 글로벌 CSP와 서버 제조사들과의 기술검증(PoC) 결과에 달려 있다.
2023년 한국과학기술원(KAIST) 김주영 교수가 설립한 하이퍼엑셀은 현재 시리즈 B 투자 유치를 진행하며 누적 2100억원의 투자금을 확보한 상태다.